← 回首頁 WHY IS ASKING A COLLEAGUE STILL FASTER THAN SEARCHING?

為什麼公司的知識,永遠是問人比查快?

AI 工具 · 2026.03 – 至今 · 產品、RAG 架構、部署維運

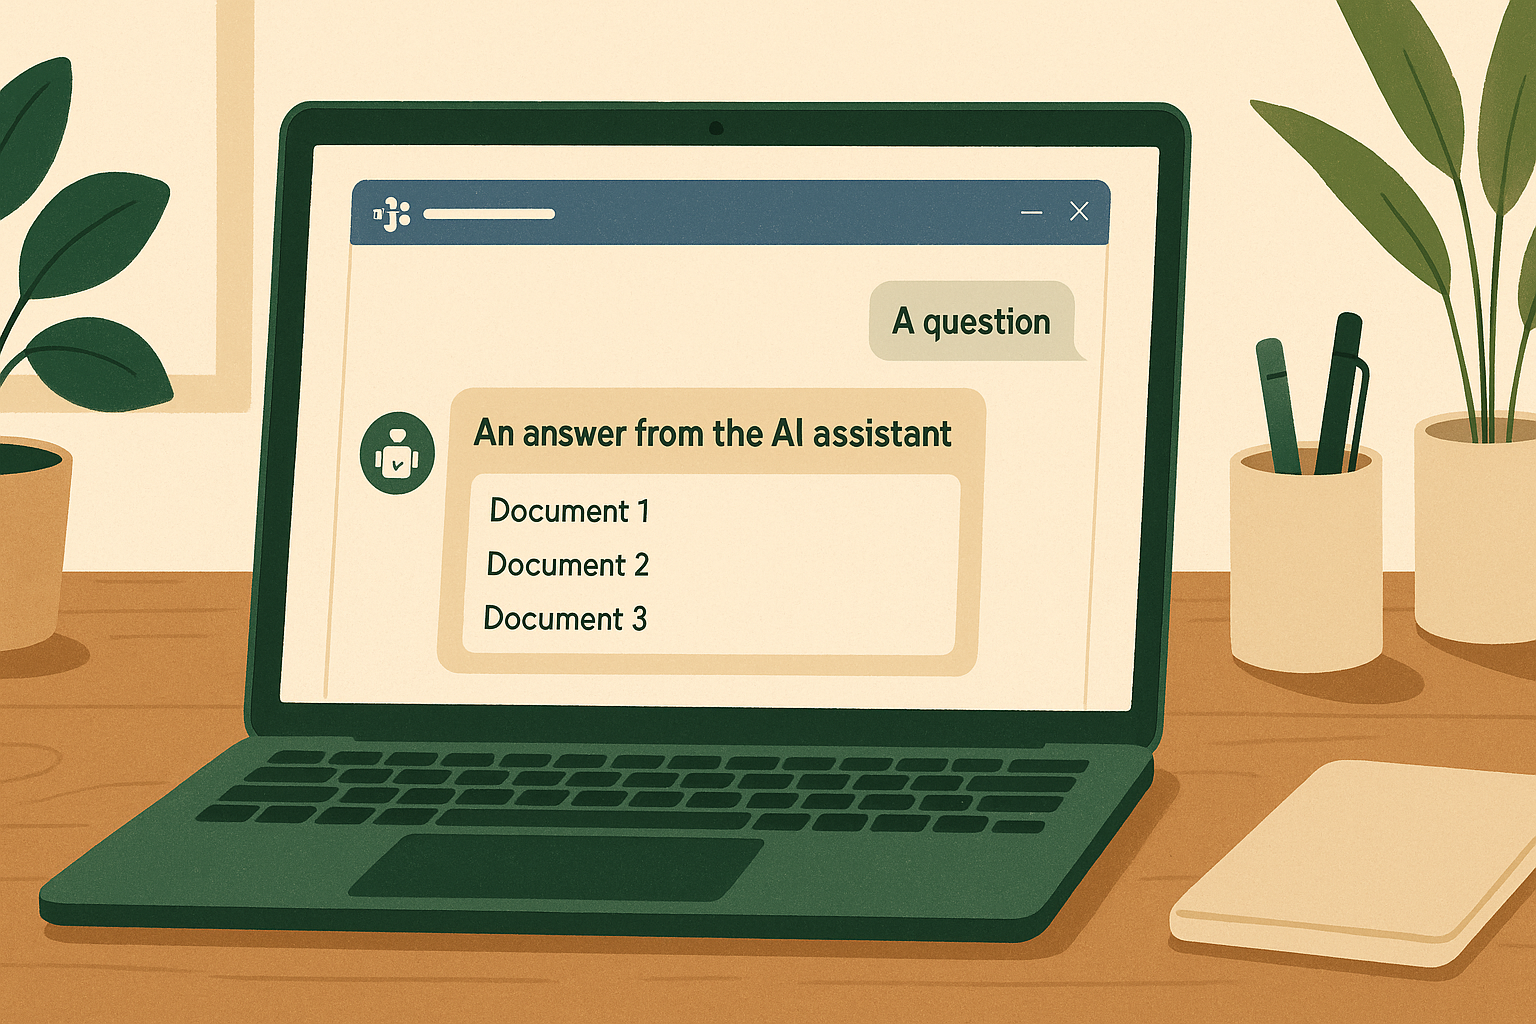
我所在的 30 人電商公司,知識散落在 Google Docs、Wiki.js 與 Notion 三套系統:HR 政策是 Word 檔、SOP 在 Wiki.js、產品規格在 Notion。新人得在不同系統間找文件,資深同事則反覆回答早已寫過的問題,KM 慢慢變成「有人寫、沒人查」。當同事一個月內第三次問我「客訴升級的流程圖在哪裡」,我決定做一個住在 Microsoft Teams 裡的 AI Bot:一次搜尋三個來源,每個回答都附出處,也能把修正後的知識寫回原系統。

0+ 索引文件
0+ 知識切片
< 3 秒 回答時間
NT$0 每月 Azure 成本
APPROACH

解決構想

我把對話入口放進大家每天本來就會開的 Microsoft Teams,再從同一個入口搜尋所有來源。 這個 Bot 負責三件事:

  1. 定時同步 Wiki.js、Google Docs 與 Notion 的內容。
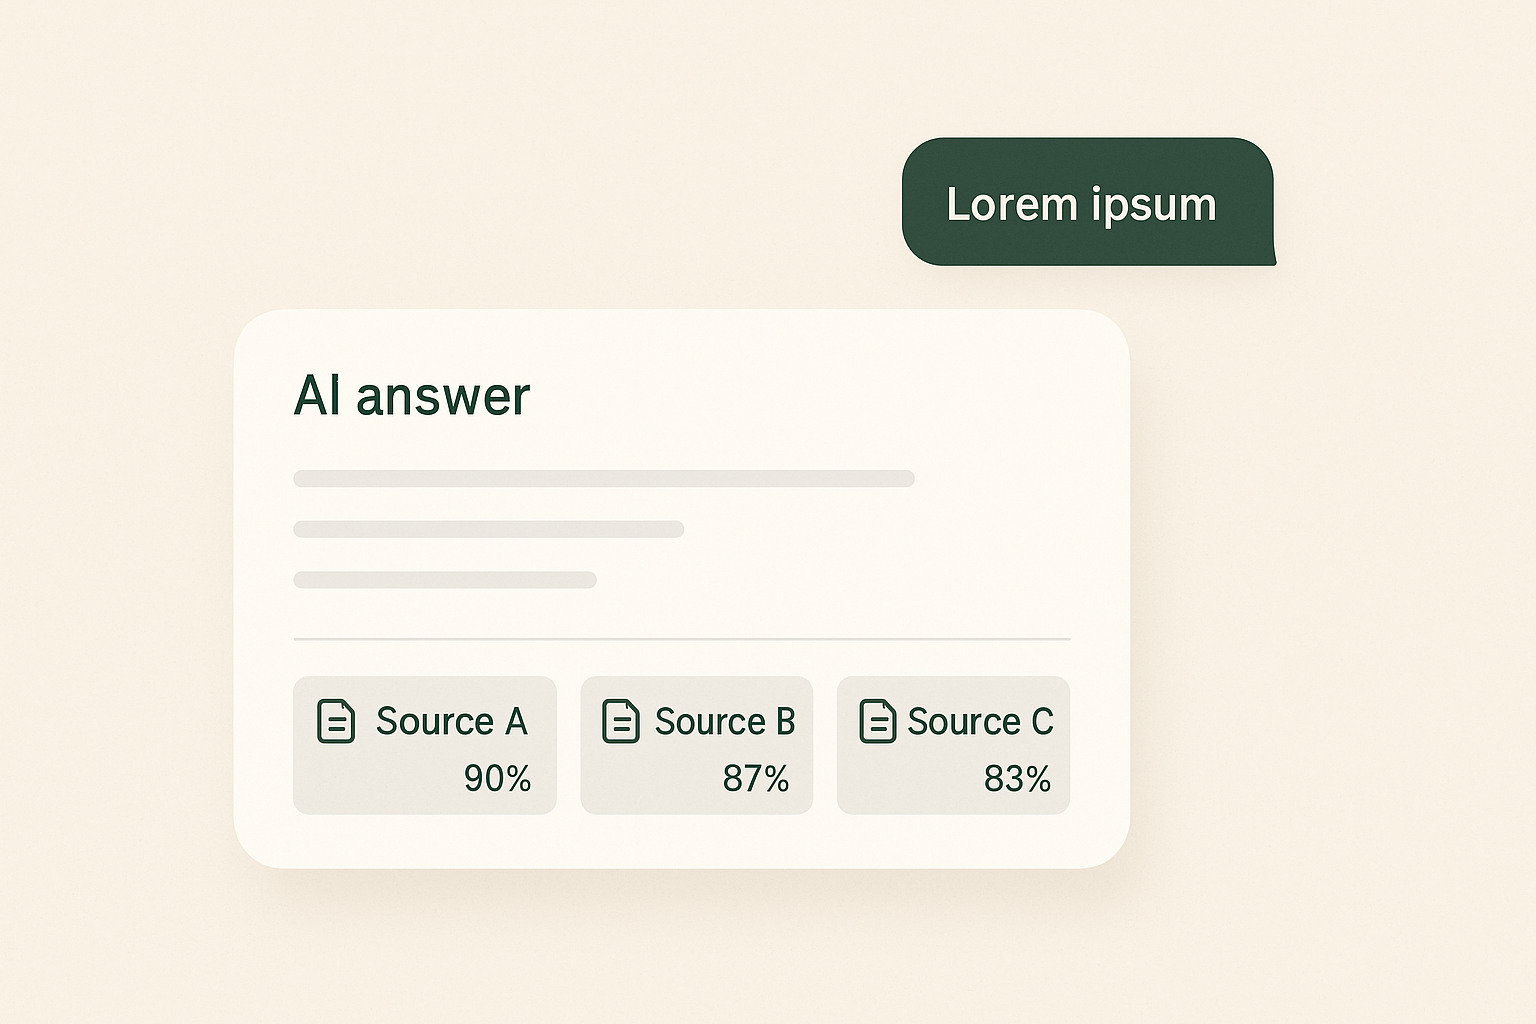
  2. 用 RAG(檢索增強生成)回答問題,並附上原文出處。
  3. 把一段隨手記透過一個指令發布成 KM 頁面,降低貢獻知識的門檻。

我設定的產品標準很直接:查詢必須比打斷資深同事更方便,否則使用者仍會回去問人。

ONE CHAT, EVERY SOURCE Wiki.js Google Docs Notion 每小時 同步 向量索引 9,600+ 個切片 Teams 聊天 回答附出處 —— 驗證 AI 只要一鍵

CHALLENGE 01

如何讓人記得用它?

知識工具常常不是因為功能不足而失敗,而是使用者想不起來要打開它。 我評估過獨立問答網站,雖然介面自由度更高,卻會多一個網址與操作習慣。放進大家每天都開著的 Teams,提問幾乎不增加切換成本;身分驗證也能直接沿用公司帳號,不必另外維護一套登入系統。

THREE DECISIONS FIRST ROADS NOT TAKEN 放哪 新做一個網站 → 住在 Teams 裡 信任 「相信 AI」 → 每個回答附出處 寫入 唯讀知識庫 → 寫回 + 稽核紀錄 知識工具的死因是沒有人記得去開它

CHALLENGE 02

如何讓人敢信 AI 的答案?

我把「AI 可能答錯」當成設計前提。 因此每個回答都附上引用的原文連結,讓使用者一鍵核對。AI 不會因為接上知識庫就自動可信;只有把驗證成本降到足夠低,使用者才有可能放心採用。

檢索品質則靠真實問法持續校準。最初的 RAG 流程是把問題 embed、做 cosine 搜尋,再生成答案;demo 看起來正常,遇到「Line 推播設定位置?」這種簡短問句卻會失準。正確文件是「Line 推播設定」,但「位置」一詞會把排名拉向 UI 設定類文件,連前五名都進不了。我在搜尋前先用 GPT 將問題展開成 2–3 個語意變體,分別搜尋後,再依每個切片的最高分合併排序,短句問題的召回率因此明顯改善。

後來我再補上語意與關鍵字加權的混合搜尋。起因是一份需求文件明明存在 Notion,換成口語問法卻完全搜不到。純語意檢索對專有名詞與產品代號較弱,「粥寶寶」對模型而言只是一串字。加入關鍵字權重後,同一個問題的文件排名從第 27 名升到第 5 名;問法完整時則能穩定排第一。

這套做法仍有明確限制:查詢展開由 LLM 執行,不是確定性流程,因此同一個問題重問,排名可能波動。我沒有把它包裝成完美檢索。更穩的方向,是讓 AI 同時取得文件與程式碼,交叉比對兩邊內容;這個判斷後來發展成另一個專案:FruitWeb 診斷 MCP。

優化檢索的輸入,必須是真實使用者的問法。 每次搜不到,我就把那個問法帶回測試與調整,讓下一次查詢更接近答案。
HYBRID SEARCH, MEASURED SAME QUESTION · SAME DOCUMENT 純語意 第 27 名 語意 + 關鍵字 第 5 名 條越短 = 越快找到 產品名對模型只是一串字 —— 關鍵字接住語意漏掉的

CHALLENGE 03

如何讓知識庫不腐爛?

如果發現錯誤的人無法順手修正,知識庫就會逐漸過期。 因此關鍵能力不只有搜尋,Bot 還必須能把修改、追加與新內容發布回三個來源。

#修改 讓同事不用學 Wiki.js 後台,就能修正錯字;#追加 用來補上 SOP 遺漏的步驟;#發布 則把隨手記整理成有標題與結構的 KM 頁面。每次修改 Notion 都會自動附加稽核註記,補足它沒有 per-block 編輯歷史的限制。能力可以開放,但每次變更都必須能追溯。

這讓真正發現問題的人可以當下修正,不必先通知某位編輯再等待處理。貢獻知識從一項需要另外排時間的工作,變成查詢與使用過程中的順手動作。
FEATURES

順手長出來的兩個功能

個人助理。 既然對話介面已經存在,我再加入筆記與提醒,讓 Bot 同時成為個人便利貼。每天 9、14、17 點的提醒推送看似簡單,正式運作後卻暴露出排程可靠性的問題,後面會談到。

全流程圖片支援。 使用者可在筆記與提醒中附圖。圖片先存入私有 Azure Blob,每次顯示才產生短期 SAS token,不留下公開 URL;筆記發布時,圖片會以 base64 嵌入 KM,或透過 Drive 上傳到 Google Docs,原始 blob 隨即刪除。我刻意縮短暫存生命週期,減少需要長期保護的資料。

暫存檔存在得越短,需要長期保護的資料就越少。 資安不只靠權限,也靠減少不必要的留存。

A PERSONAL ASSISTANT ON THE SIDE THE UI WAS ALREADY THERE 筆記 隨手記 → 保留 → #發布 提醒 09:00 · 14:00 · 17:00 圖片 兩者都能附 每日推送背後有個工程故事 —— 見下方教訓
SHORT-LIVED BY DESIGN IMAGE PIPELINE 上傳 私有 Blob 沒有公開 URL 短效 SAS token 發布 → 刪除 blob 你沒有留的資料,永遠不會從你這裡外洩

RESULTS

實際運作狀況

系統從 2026 年 3 月運作至今,穩定維持 690+ 份文件、約 9,600 個索引切片與三個知識來源;每小時同步一次,回答時間 < 3 秒,每月 Azure 成本約 NT$2,500。7 月加入使用遙測後,我也開始能用數據觀察實際使用分佈,而不是只靠身邊回饋。

最有意思的不是技術指標,是使用樣態:

  • 客服在電話中用它即時查詢政策門檻。
  • 新人把它當成自助 onboarding 工具,HR 少了許多「表單在哪裡」的中斷。
  • 一群進階使用者習慣了 #發布 流程,Bot 也成為他們主要的知識貢獻入口。

我也觀察到知識庫比過去更快累積內容。不是因為增加了寫文件的要求,而是發布門檻降低後,貢獻自然發生在使用過程裡。

IN PRODUCTION SINCE MARCH 2026 MEASURED, NOT OBSERVED 690+ 文件 約 9,600 切片 < 3 秒 回答 NT$2,500 /月 每小時同步 · 3 個來源 · 7 月起有使用遙測

LESSONS

只有正式環境教得會的事

  • node-cron 會悄悄失效。 process 長時間運行時,整點排程可能停止,但短週期排程(*/5)仍在運作。我第一次部署的修正只會在重啟時生效,偏偏 Bot 沒有重啟。最後改用每 10 分鐘輪詢做安全網,不再單獨依賴 cron。
  • Azure App Service 預設用 32-bit worker,Node heap 被砍到 90MB,跟 --max-old-space-size 設多少無關。6000 個切片就 OOM。一行 CLI 就能切換。
  • wwwroot 在 zip-deploy 時會被清空。 如果 vector store 放在其中的 data/,部署時也會一起消失。我曾因此遺失整個知識庫,後來改用環境變數將路徑指向持久化目錄。
  • Teams 傳來的 content-type 是 image/*(通配符,不是實際 mime),而且 contentUrl 需要 Bearer 認證才能下載。一連串錯誤假設要慢慢拆掉。
  • 為了省上傳時間做增量部署,造成兩次正式環境中斷。 完整包 110MB,增量包只有 1.2MB,所以我一度只上傳改動、沿用伺服器上的 node_modules,結果 app crash loop 十分鐘。從 Kudu 的 iisnode 堆疊才發現,遙測套件讀到一個寫入不完整的第三方模組;根因不是應用程式碼,而是增量部署讓伺服器套件狀態不一致。改回完整 zip 一次替換後才恢復穩定。
  • 完整部署會把不在包裡的東西刪掉。 修好上面那件事之後,完整包裡沒有 web/ 資料夾,部署時就把網頁版聊天介面的首頁刪了(Teams 端沒事,所以差點沒發現)。補一個 web-only 的包回去才恢復。

每次中斷我都留下根因分析,兩次部署事故最後變成一條硬規則:這個服務永遠使用完整包一次替換,不做增量部署。規則也直接寫進部署腳本,不再依賴操作人員記得。

完整的 postmortem 在 repo 裡,包含架構選擇、和我會重做的部分。

ONLY PRODUCTION TEACHES THIS SIX BUGS THAT SURVIVED TESTING cron 悄悄失效 32 位元 heap 上限 · OOM 部署時 wwwroot 被清空 image/* 萬用 MIME 增量部署 ×2 次中斷 完整部署會刪掉 缺的是 每次中斷 → 寫 RCA → 變成部署腳本裡的規則 完整包 · 一次替換 · 不做增量 —— 規則不靠記性

NEXT

下一步計畫

  • 圖片 OCR:很多 SOP 把關鍵資訊放在截圖裡,純文字 RAG 看不到。在同步階段對圖片做一次 vision pass。
  • 可換的 LLM provider:現在綁 Azure OpenAI 是有實務理由的(亞洲直連 OpenAI / Anthropic 會 403),但抽象一層 interface 就能換到 OpenAI / Anthropic / Bedrock。
NEXT 同步時做圖片 OCR 截圖 → 可搜尋 可換的 LLM provider 只差一層 interface 綁 Azure 是實務理由 —— 區域 403 —— 不是架構限制

STACK

技術架構

TypeScript、Node.js、Azure OpenAI(gpt-4.1 + text-embedding-3-small)、Microsoft Bot Framework、Wiki.js GraphQL、Google Drive API + Docs API、Notion API、Azure Blob Storage、Azure SQL、Application Insights。部署在 Azure App Service。

原始碼在 GitHub(jean199801/teams-knowledge-assistant)——README 有完整的架構說明,需要技術細節可以看。

ARCHITECTURE Teams Bot · Node/TS Azure App Service RAG + 寫回 Azure OpenAI · GPT-4.1 + Embeddings 私有 Blob · 短效 SAS Wiki.js · GDocs · Notion 同步進來 · 稽核寫出去 每小時同步 · 每次寫入留稽核註記